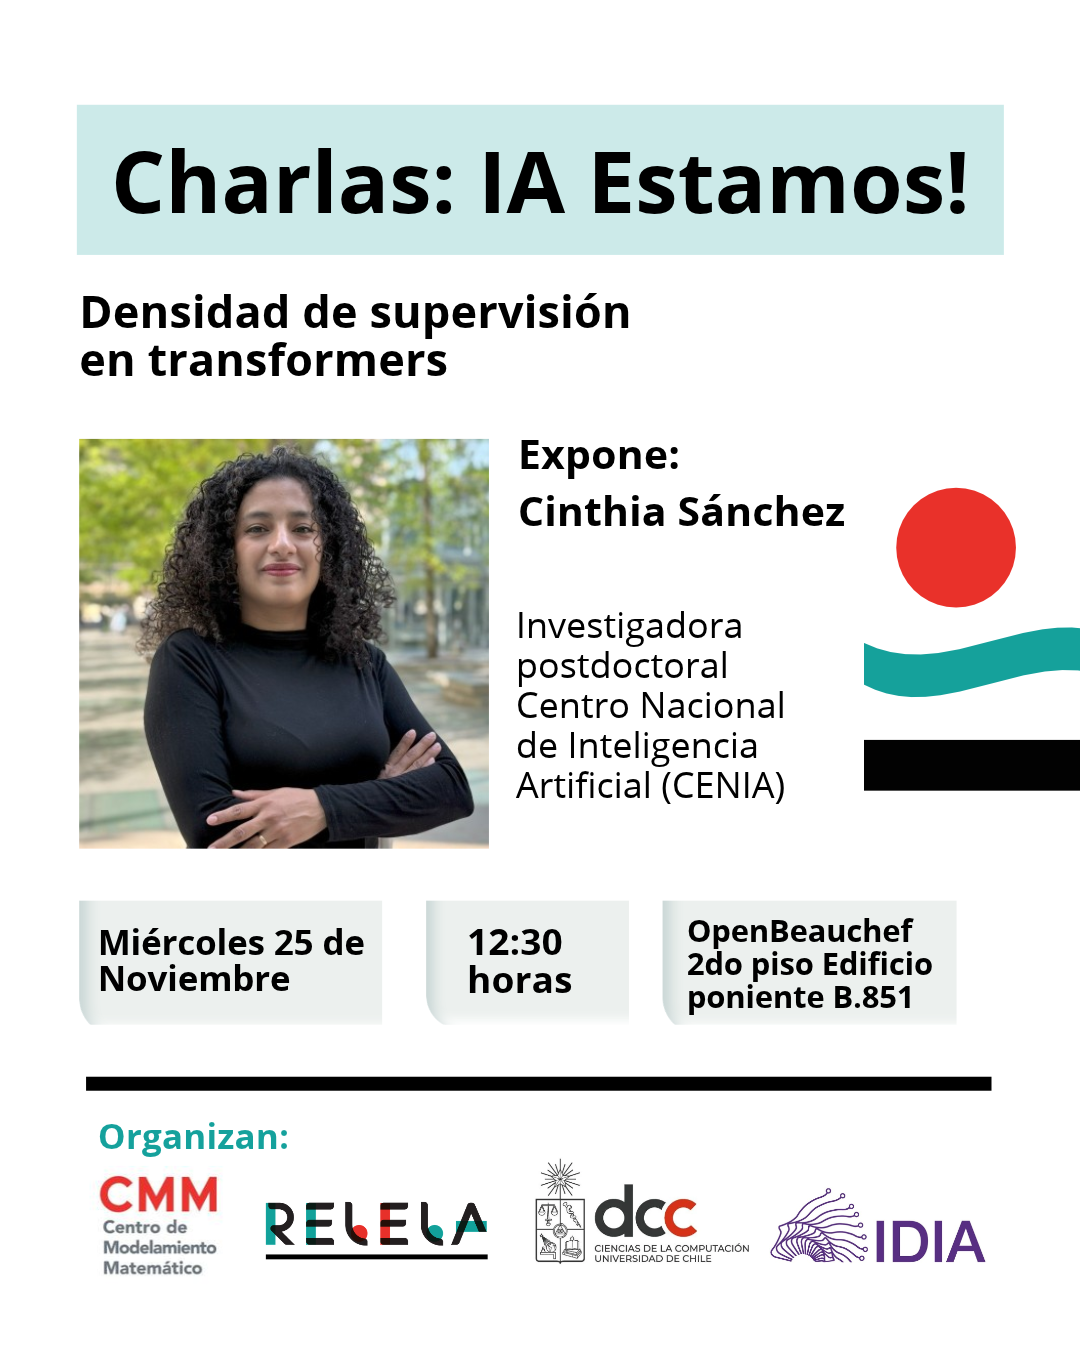
Fecha: miércoles 25 de noviembre.
Lugar: OpenBeauchef, 2.º piso, Edificio Poniente, B.851.
Hora: 12:30 horas.
Resumen de la Presentación
Al entrenar un Transformer en una tarea, debemos decidir qué posiciones de la secuencia participan en la función de pérdida (loss) de predicción del siguiente token (next-token prediction). Por ejemplo, podemos supervisar toda la secuencia o únicamente el token de respuesta. ¿Cómo condiciona esta elección la solución que aprende el modelo?
En esta charla estudiaremos esta pregunta a través de la tarea de variable binding multi-hop (a=7, b=a, c=3, d=b → ¿d?), entrenando modelos Transformer decoder-only desde cero con distintas densidades de supervisión, es decir, variando la fracción de tokens supervisados.
Veremos cómo esta decisión afecta la dinámica de convergencia, la generalización a programas más largos y con más saltos, y los mecanismos internos que el modelo desarrolla para resolver la tarea.